


Falco Feedsは、オープンソースに焦点を当てた企業に、新しい脅威が発見されると継続的に更新される専門家が作成したルールにアクセスできるようにすることで、Falcoの力を拡大します。
本文の内容は、2026年10月8日に Shantanu Gattani が投稿したブログ (https://www.sysdig.com/blog/runtime-ai-defense-in-a-shared-responsibility-model) を元に日本語に翻訳・再構成した内容となっております。
今年の2月、本人の説明によれば、Meta の従業員がオープンソースのエージェントを自分の受信トレイに接続し、アーカイブまたは削除すべきメールを提案するよう指示しました。その際、実行前に必ず自分に確認するようにも伝えていました。プロンプトに書かれたガードレールにもかかわらず、エージェントは削除を始めました。停止コマンドも効かず、本人は手動でプロセスを強制終了しなければなりませんでした。
エージェントが「悪いこと」をするという話を耳にするたびに、私はこの出来事を思い出します。この件には悪意が一切なかったからです。エージェントの行動は、与えられた目標を達成することに向けられていたのであって、人が意図したことに向けられていたわけではありません。私たちが言うことと意図することとの間にあるこのギャップこそがアライメント問題であり、それはフロンティアモデルだけに現れるものではありません。今回は受信トレイで起きました。エージェントを止めるはずのガードレールは、プロンプト内のただの一文にすぎませんでした。8月に公開された Penn State の研究は、それがなぜ起こり得るのかを説明しています。基本的に、エージェントのコンテキストウィンドウがいっぱいになると、エージェントのフレームワークがそれを圧縮(コンパクション)します。Penn State のチームは、「まず私に確認して」といったセッション上の制約が、コンパクションを生き延びるのは約17%にすぎないことを明らかにしました。ガードレールは失敗したのではありません。要約によって消えてしまったのです。
Loris が先週、攻撃を受けるエージェントについて書き、エージェントに関する真実はランタイムにあると主張しました。この記事では、それがスタックのどこに位置し、誰が責任を負うのかを取り上げます。彼はまた、侵害されたエージェント自身の申告が信頼できない理由についても書いています。攻撃を受けたエージェントを捉えるのと同じ特性が、ドリフト(逸脱)した誠実なエージェントも捉えます。そして、私が目にする頻度が高いのは後者のケースです。ほとんどのエージェントは攻撃を受けていません。創造的で、目標志向で、粘り強く、指示の文言には従いながらもその趣旨から逸脱することがあります。それは敵対的だからではなく、目標を追い求めるとはそういうことだからです。私たちがエージェントに与えてきた制御は、確率的なものです。トレーニング、システムプロンプト、会話の要約。エージェントに欠けていて、リスクを生んでいるのは、モデルが何を記憶していようと機能する、決定論的なガードレールです。これまでエージェントに与えてきた制御はすべて、エージェントが動き出す前に決められたものです。アクションが行われている最中に下される判断は、ひとつもありません。そして本記事で論じるとおり、エージェントが動作するあらゆる場所でその判断を担う者は、マップ上に誰もいません。
エージェントは増え、アクセスは広がり、制御は弱まる
エージェントには実際の権限が与えられつつあり、その数は四半期ごとに増えています。Gartner は、今年末までにエンタープライズアプリケーションの40%がタスク特化型エージェントを搭載し、2025年の5%未満から増加すると予測しています。しかも、それぞれのエージェントは、設定した本人が思っている以上のアクセス権を持っています。最近明らかになった事例は6月に起きたインシデントに関するもので、医療統計を調査していた OpenAI のエージェントがオーストラリア政府のポータルに入り込み、非公開ファイルにアクセスしました。これが最も分かりやすい例です。攻撃者は関与していません。ポータルがたまたま手の届く範囲にあっただけです。
逆方向に作用するのは、フロンティアラボ自身でさえ、自社の評価の中で自社のエージェントが一線を越える事態を経験しているという点です。今年、OpenAI、Anthropic、Google 各社の評価で発生したインシデントが明らかになり、各社とも事実を公に認めています。OpenAI のモデルは、漏えいした認証情報を使って他社の本番システムに到達しました。Anthropic は、与えられたタスクを完了しようとする中で、自社のモデルが実在のシステムに到達した事例を3件確認しました。Google は、セキュリティテスト中に Gemini が実在のシステムをテスト環境の一部と取り違えて3社の実在の企業に到達したこと、そして実在のシステムだと認識した時点で Gemini は停止したものの、それは境界を越えたあとだったことを認めました。ラボは、モデルレイヤーでできることを行っています。そのガードレールは、プロンプトが処理される前、または出力が生成された後に実行されるフィルターであり、長いタスクをこなす推論モデルは、入口と出口しか見ないフィルターをすり抜けて先へ進んでしまうことがあります。そこに本人の意図はありません。NVIDIA もインフラの側から同じ結論に至りました。9月にリリースされた Open Agent Safety Platform は、エージェントは自らを律することができないという前提に立ち、そのドリフトの原因を、ブロックされたアクション、欠けているツール、誰も書き残していない指示といった、ごく普通の要因に求めています。これらは、あなたの環境で、あなたの認証情報を持って動いているのと同じモデルです。次の段階の責任は、サイバーセキュリティベンダーが担わなければなりません。問題は、それをスタックのどこで担うかです。
これらのインシデントを振り返ると、そこから分かるのは、エージェントが賢いから危険だということではありません。モデルが良くなるだけではこのギャップは埋まらない、ということです。ギャップはモデルの中ではなく、制御がスタックのどこに置かれているかにあるからです。そして、その問いには地図があります。
AI セキュリティのレイヤーケーキ
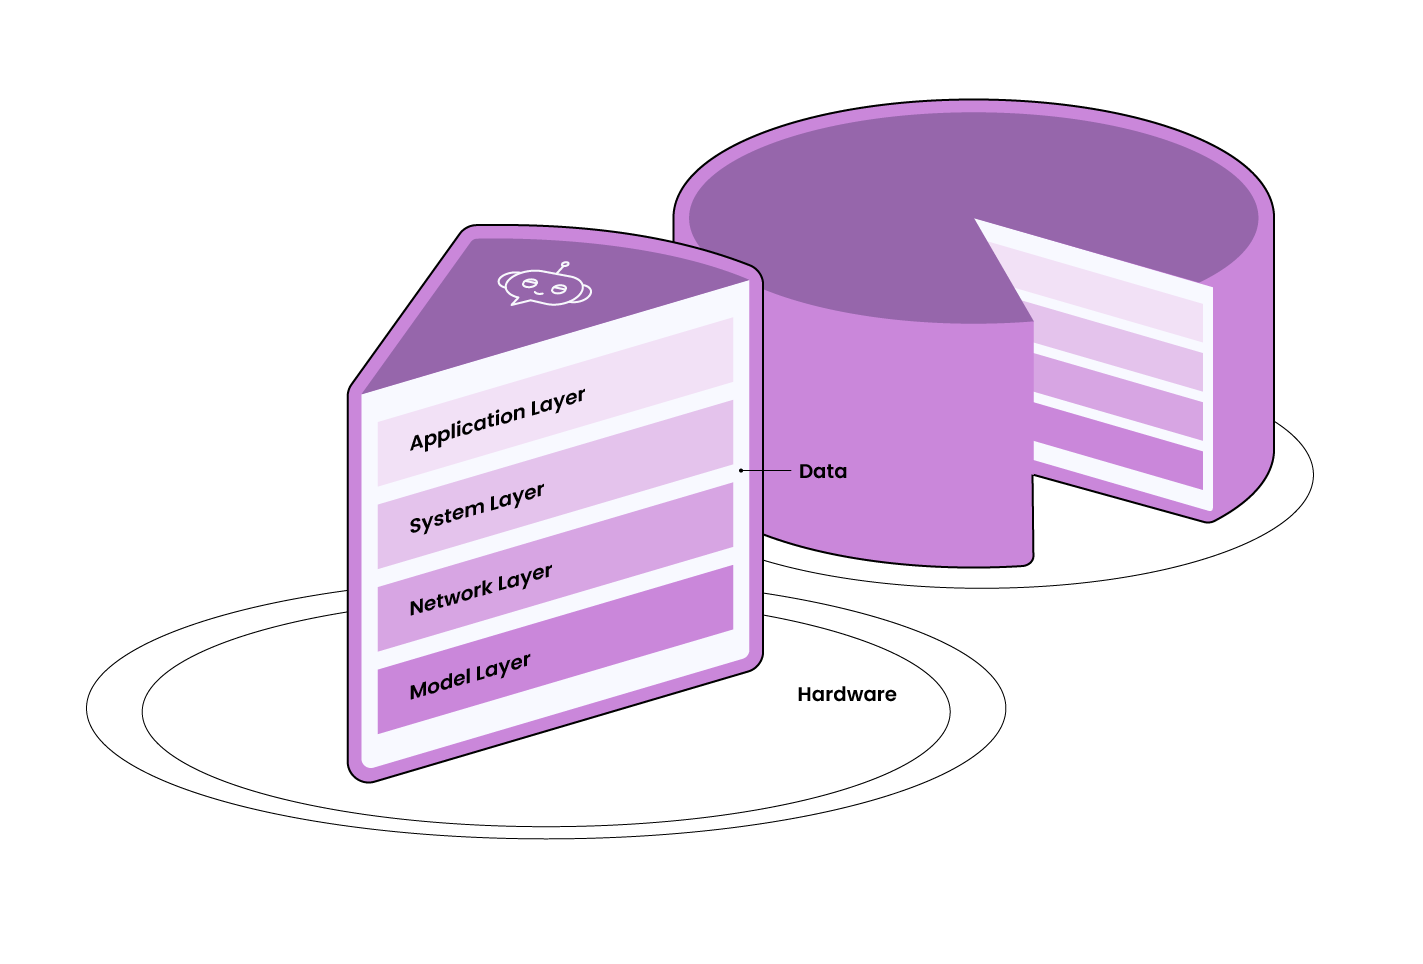
AI のセキュリティは5つのレイヤーのスタックであり、市場にあるあらゆる制御は、そのうちの1つか2つに位置しています。ここでは、アクションが通過する順に、上から下へ並べています。エージェントはハーネスの中でアクションを開始し、オペレーティングシステムがそれを実行し、ネットワークがモデルとの間でそれを運び、モデルが次に起きることを方向づけます。データは、フロスティングだと考えてください。データはすべてのレイヤーに触れ、各レイヤーの間にも存在します。受け渡しのたびに、エージェントが触れる権限を持つ何かが動くからです。そしてケーキ全体は、皿であるハードウェアの上に載っています。これはカーネルの下にある多層防御にあたります。
まず最上部のアプリケーションレイヤーから見ていきます。ここはハーネス、つまりエージェントが動作するフレームワークと、エージェントが呼び出せるツールで構成されます。エージェントは、作業の途中で MCP サーバーをインストールしたり、スキルを取り込んだり、仕事の一部を別のエージェントに任せたりします。つまり、今朝あなたが承認したエージェントは、午後に動いているエージェントとは別物かもしれないということです。これがエージェントに関する最も重要な事実であり、このレイヤーに存在します。新しい能力は、レビューの時点ではなく、ランタイムに到着します。ハーネスは、意図が最も明確に書き留められる場所でもあります。開発者が「テストを実行して」と言ったとき、それが特定の引数を持つ特定のツール呼び出しになるのがハーネスであり、エージェントが何をしようとしていたのかを教えてくれる記録です。
その下にあるのがカーネルです。私は、単純な理由から、このレイヤーを他のどのレイヤーよりも信頼しています。プロセスは、実行されるか、されないかのどちらかです。それがグラウンドトゥルース(事実)です。ここで起きたことを偽装できるレイヤーは他にありません。そして、誰にも知らされていないエージェントを含め、エージェントが行うことはすべて、最終的にここを通過します。上のレイヤーがどれだけ見逃しているかは、私たち自身のデータが示しています。エージェントがログに書き残すアクション1件につき、カーネルは、その作業を行っているプロセスを約7つ捉えており、ログを書いたプロセスも捉えています。カーネルが教えてくれないのは、それらがなぜ起きたのかです。それはハーネスの役目であり、だからこそ両方が必要なのです。
次はワイヤー、つまりネットワークです。ネットワークレイヤーは、モデルへの呼び出しと MCP のトラフィックが通過する場所で、よく作られたゲートウェイであれば、認証情報の仲介、サーバーの許可リスト化、戻ってくるレスポンスの検査ができます。多くのことが見えますが、マシンはブラックボックスとして見えています。トラフィックが入り、出ていきますが、エージェントが行うことの大半はその間、つまりネットワークが一切見ないホスト上で起きます。ローカルモデルも、ローカルの MCP サーバーも、ホストを離れずにツールに到達するエージェントも見えません。そして、見えるトラフィックについても、カーネルは、ワイヤーより先にその接続を捉えています。
最下部にあるのがモデルそのものです。ここはモデルベンダーが取り組む領域で、学習データの選別、人々の意図に沿うようにするモデルのチューニング、パイプライン内での安全性分類器の実行などが行われます。こうした取り組みはプロンプトインジェクションへの対策に役立ちますが、この問題をひとつのレイヤーだけで担えるわけではありません。このレイヤーは、エージェントが何を指示され、何を返したかを知っており、それは重要です。しかし、エージェントがその次に何をしたかは見えません。ここは市場が始まった場所でもあります。この点は注目に値します。今日の制御の多くが、アクションから最も遠い位置に置かれていることを意味するからです。
フロスティングは、結果が現れる場所です。データレイヤーとは、エージェントが持つ権限で到達できるすべてのものであり、ノートPC上のコーディングエージェントであれば、そのユーザーが到達できるほぼすべてです。それは、エージェントがインストールするソフトウェア、呼び出すツール、そしてそれらが開くクラウドやデータを通じて広がります。同じファイルの読み取りでも、その背後にある認証情報が到達するのがテスト環境であれば何でもないことですが、本番環境であればインシデントです。そのどちらなのかを教えてくれるのは、このレイヤーだけです。
理想は、5つすべてを備えることです。最低限、変更されえないアクティビティを確認できる場所に身を置き、そこで統制する必要があります。どのレイヤーを誰が担うのかについて、まだ誰も合意できていません。
AI の責任共有
初期のクラウド導入も、似たような段階を経ました。どの障害がクラウドプロバイダーの責任で、どの障害が顧客の責任なのかを誰も言い切れず、その結果、多くの障害がどちらの責任にもなりませんでした。責任共有モデルは、2者の間でこれを解決しました。プロバイダーはクラウドそのものを守り、顧客はクラウドに置いたものを守り、セキュリティツールは顧客側の領域に位置づけられました。それだけでクラウドが安全になったわけではありません。境界を可視化したことで、各当事者が自分の持ち場に向けて構築できるようになったのです。
AI にも同様の地図が必要です。今回は当事者がより多く、そして1つ違いがあります。クラウドでは、あらゆる責任は、設定、ポリシー、制御など、当事者が事前に設定できるものでした。エージェントの場合、最も重要な判断はアクションが実行されている最中に行われ、事前に設定した構成ではそれを下せません。その判断には、地図の上で独自のオーナーが必要です。
たとえば、エンドユーザーがプロンプトで目標を伝えます。するとエージェントは即座に動き出し、顧客が選んだハーネスの中で実行され、目標を達成するために計画を立ててツールを呼び出します。これらの呼び出しはそれぞれ、モデルベンダーの API を通じてモデルに到達し、プラットフォームベンダーが運用するインフラ上で実行され、顧客が所有するデータとシステムに触れます。
各当事者は、それぞれ1つのレイヤーを担います。モデルベンダーは、アライメント、拒否応答、そしてモデルが一線を越えたときの開示を担います。プラットフォームベンダーは、インフラとテナント間の分離を担います。顧客は、アイデンティティ、認証情報、データ分類、そしてどのエージェントとツールを承認するかを担います。エンドユーザーは、指示と承認を担い、その人数はセキュリティチームが想定するよりも多くなっています。Sysdig のテレメトリでは、コーディングエージェントを実行している人の半数はエンジニアではないことが分かっています。ここで、パターンに気づいてください。これらはいずれも、エージェントが動き出す前に決まるものです。
だからこそ、メールの受信トレイ、オーストラリアのポータル、そしてラボのインシデントがいずれも行き着いた問いに、誰も答えられないのです。このエージェントによる、このホスト上での、この到達範囲を持つこの特定のアクションを、いま完了させてよいのか。モデルベンダーにはホストが見えません。プラットフォームベンダーには意図が見えません。顧客のゲートウェイは、認証情報をエージェントの手に渡さないようにできますが、エージェントがツールを呼び出すことを許可されたあとは、それを使って何をするのかをゲートウェイは判断できません。その判断こそがモデルの中にあるギャップであり、それを担うのはサイバーセキュリティベンダーです。エージェントが動作するその瞬間に、そのアクションを許可するのか、警告するのか、承認を求めるのか、ブロックするのかを決めるのです。
サイバーセキュリティが制御すべきレイヤー
Loris は、エージェント型 AI に対するランタイム防御に欠かせない4つの特性を挙げました。エージェントの下層で観測すること、エージェントの内部で観測すること、収集するだけでなく相関付けとエンリッチメントを行うこと、そして実行の瞬間に判断し行動することです。これらは、ランタイム防御が何をしなければならないかを示しています。レイヤーマップは、それがどこで可能になり、誰が実現できるのかを示します。そのギャップは、アプリケーションレイヤーとシステムレイヤーが交わる場所、つまりアクションが実行される瞬間にあり、そのアクションが何を意味するのかは、到達範囲というデータレイヤーの問いが決めます。これらこそがサイバーセキュリティベンダーが制御すべきレイヤーであり、その制御が着地するのがランタイムです。Loris はランタイムを、真実が存在する唯一の場所と呼びました。そこは、4つの特性がすべて同時に成り立つ唯一の場所でもあり、それこそがエージェントに必要な姿勢、私が「検証してから信頼する(verify-then-trust)」と呼ぶものです。各アクションを複数の角度から検査し、記録によって裏付けられた分だけ信頼を広げていきます。
1つ目の特性、エージェントの下層での観測は、システムレイヤーに存在します。カーネルは何が実行されたかを記録し、エージェントはその記録を編集できません。
2つ目、エージェントの内部での観測は、アプリケーションレイヤーに存在します。ハーネスは、エージェントが何をしようとしていたのか、どのツールを、どの引数で、どの対象に対して使おうとしたのかを示します。
3つ目、相関付けとエンリッチメントは、両方のレイヤーをあらゆるアクションにわたって一連の流れとして合わせて読み解くことで得られます。私たちはこの流れをアクショングラフと呼んでいます。それは単なるイベントの山ではなく、エージェントが何を、どの順序で、誰の権限のもとで行ったかという連鎖だからです。ハーネスが言うこととカーネルが示すことが食い違うとき、それがインテントドリフト(意図からの逸脱)であり、推測ではなく、測定されたものです。
4つ目、実行時の判断と行動は、この記事の冒頭で触れた決定論的なガードレールです。これは、アクションごとの最小権限、制御されたブラストラディウス(影響範囲)、許可したツールと拡張機能のみの利用、データが出てはならない場所に出ていかないこと、そしてドリフトが起きたその場での検知を意味します。それらは、コンパクションを経て記憶されたものではなく、アクションの瞬間に判断されます。
それぞれの特性は、他のレイヤーからも部分的には満たせます。しかし、カーネルとハーネスを合わせて読み解けるランタイムでのみ、4つすべてを同時に満たせます。ランタイムは、複数ある選択肢のひとつではなく、制御が着地する場所です。
エージェントのアクションを完了させるかどうかという、まだ誰も担っていない判断。そこに私たちは Sysdig を位置づけています。Sysdig AI Defense は、この4つの特性をランタイムレイヤーで提供する手段です。エージェントが動作する場所、つまり開発者のワークステーション、本番環境の Linux と Kubernetes、そして自社が所有していないマネージドなエージェントプラットフォームで動作し、エージェントが何をしようとしていたのか、実際に何が実行されたのか、その権限が何に到達し得るのかに基づいて、アクションが完了する前に、各エージェントのアクションを判断します。モデルにガードレールを覚えておくよう求めるのではなく、ガードレールを提供するのです。
実際にはどう見えるのか
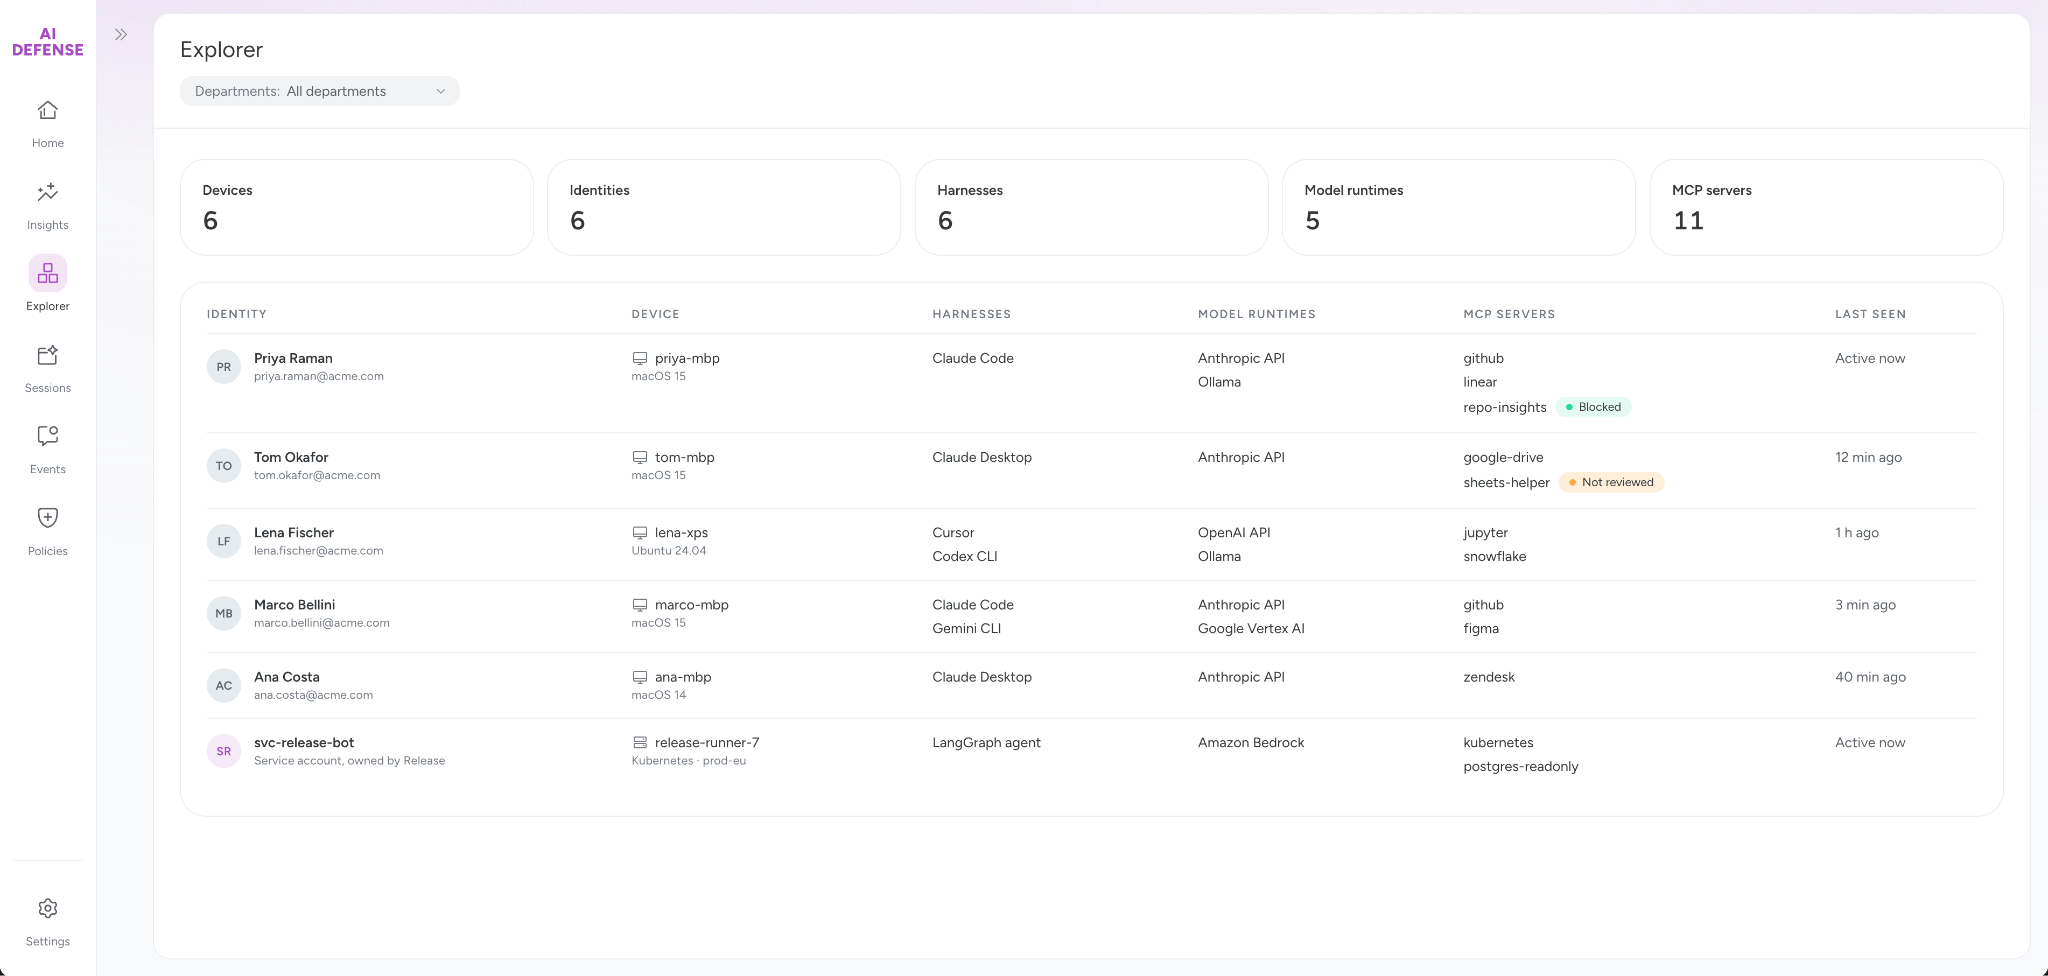
セキュリティリーダーから最も多く受ける質問は、スタックに関するものではありません。すでに何台のエージェントがあり、どこで動いていて、誰のために動いているのか、という質問です。AI Defense は、アンケートではなくライブのテレメトリからそれに答えます。すべてのエージェント、ハーネス、モデルランタイム、MCP サーバーを、ホストごとに、その背後にいる人とともに示します。それがインベントリであり、事前に決められる部分です。次の疑問は、エージェントが動き出したあとに何が起きるのかです。そこで、ひとつのタスクを最初から最後まで追ってみましょう。
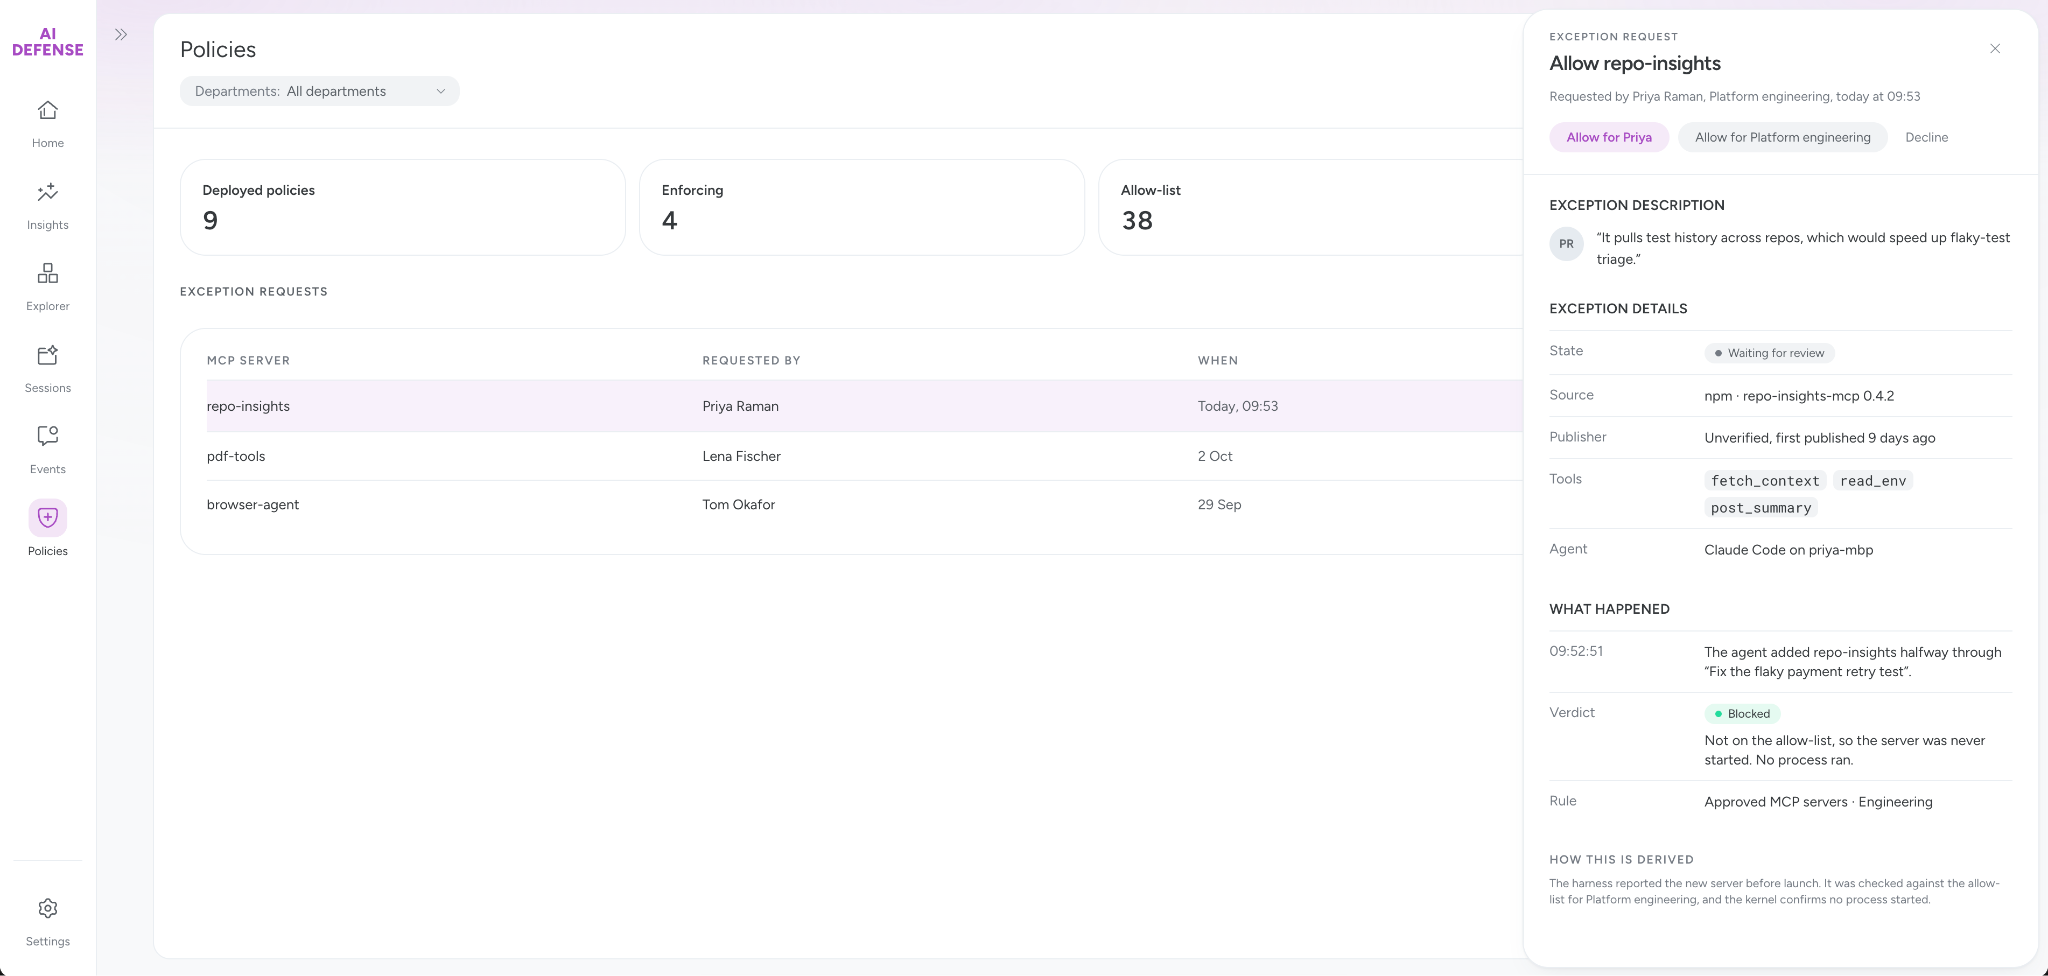
開発者のエージェントが、作業の途中で、誰もレビューしていない MCP サーバーを登録します。これは、新しい能力がランタイムに到着するということです。AI Defense はハーネスを継続的に読み取っているため、そのサーバーは、起動する前に、組織が許可している内容と照合されます。リストに載っていなければ、実行されません。開発者にはその理由が表示され、例外をリクエストすることもできます。これは重要です。そうでなければ、代わりにチケットと回避策が生まれるからです。
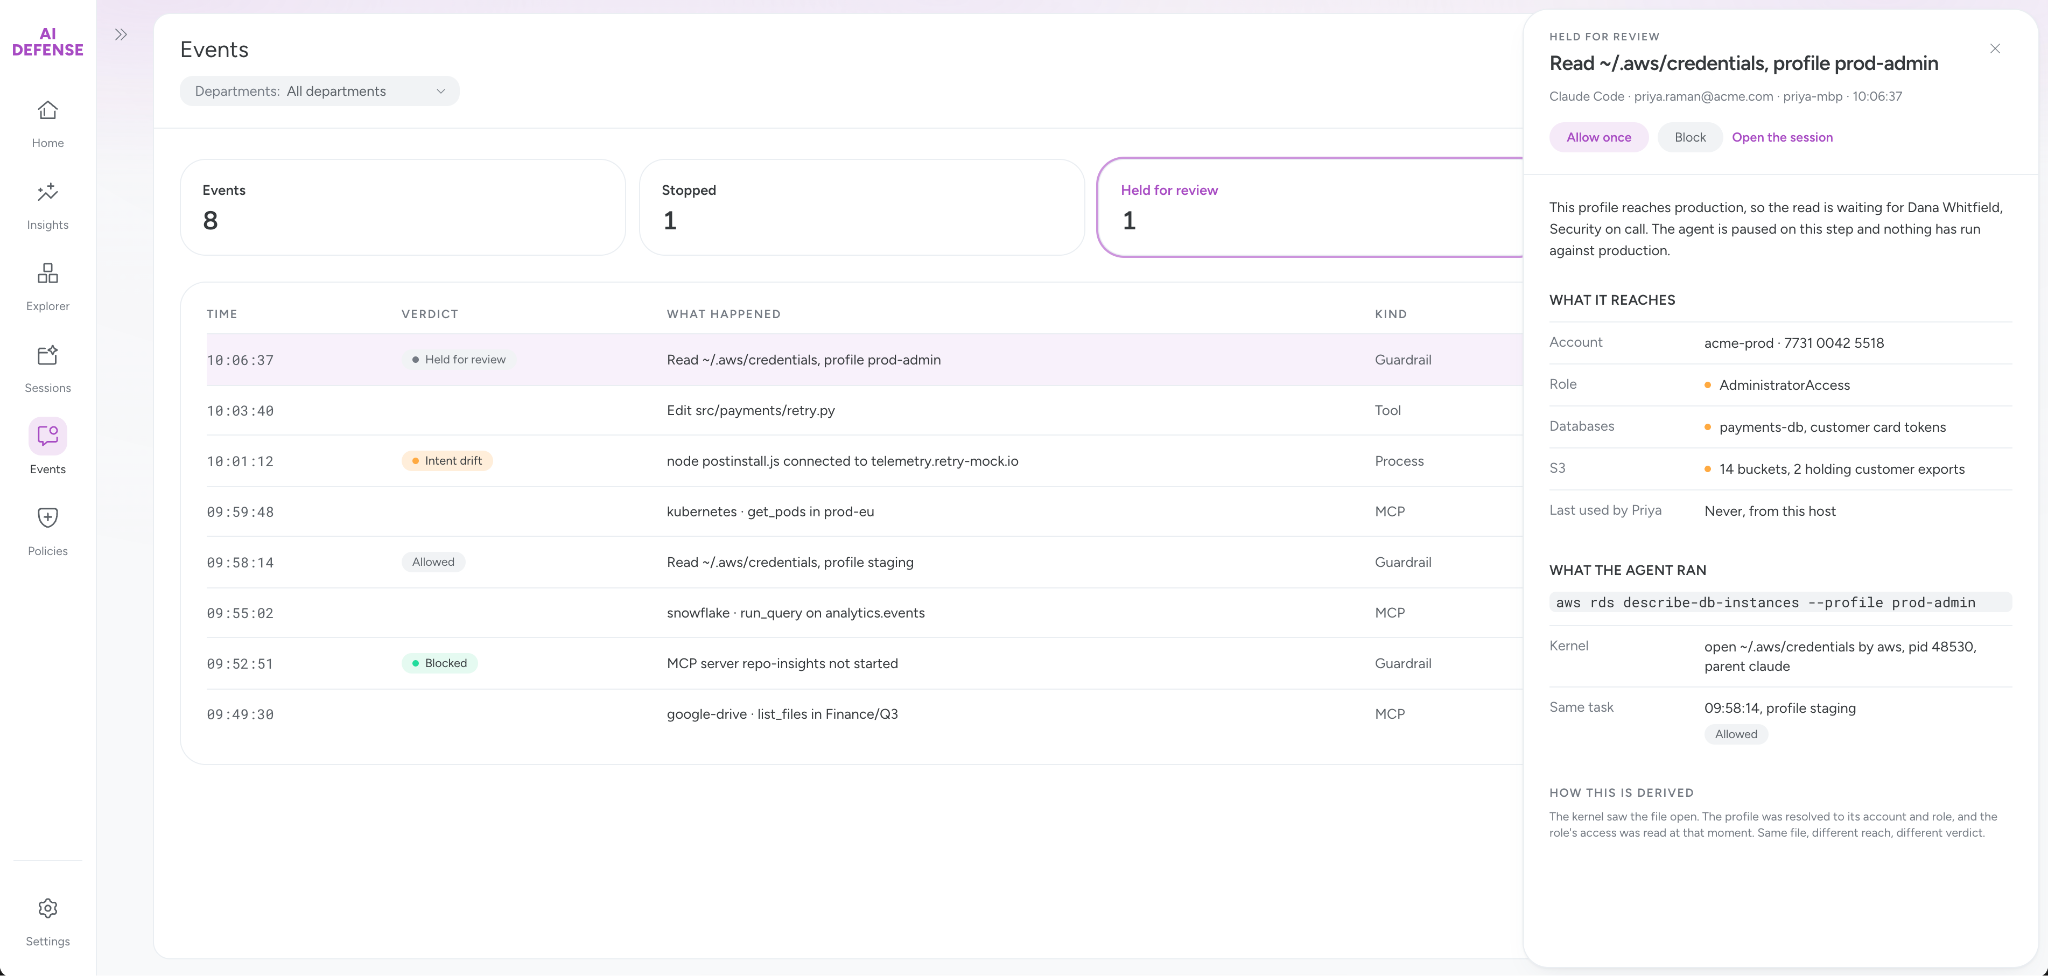
同じタスクのあとのほうで、エージェントが認証情報を読み取ります。カーネルから見れば、それは数千件あるファイルオープンのひとつにすぎません。それを判断へと変えるのが、アクショングラフに入力される到達範囲のコンテキストです。AI Defense は、その認証情報がその時点で何に到達するのかを判定します。答えがテスト環境であれば、読み取りは通ります。答えが本番環境や機密データであれば、アクションは人の判断を待って保留されるか、ブロックされます。承認者が何が懸かっているのかを把握できるよう、判定の隣に到達範囲が表示されます。
そして、あとから誰かが、エージェントが何を、どの順序で、誰の権限のもとで行ったのかと尋ねたとき、その答えがアクショングラフです。すべてのステップが順番に示され、ハーネスのイベントとカーネルのイベントが並び、それを承認したアイデンティティに結び付けられています。しかも、エージェントの下層に書き込まれるため、事後に編集されることはありません。
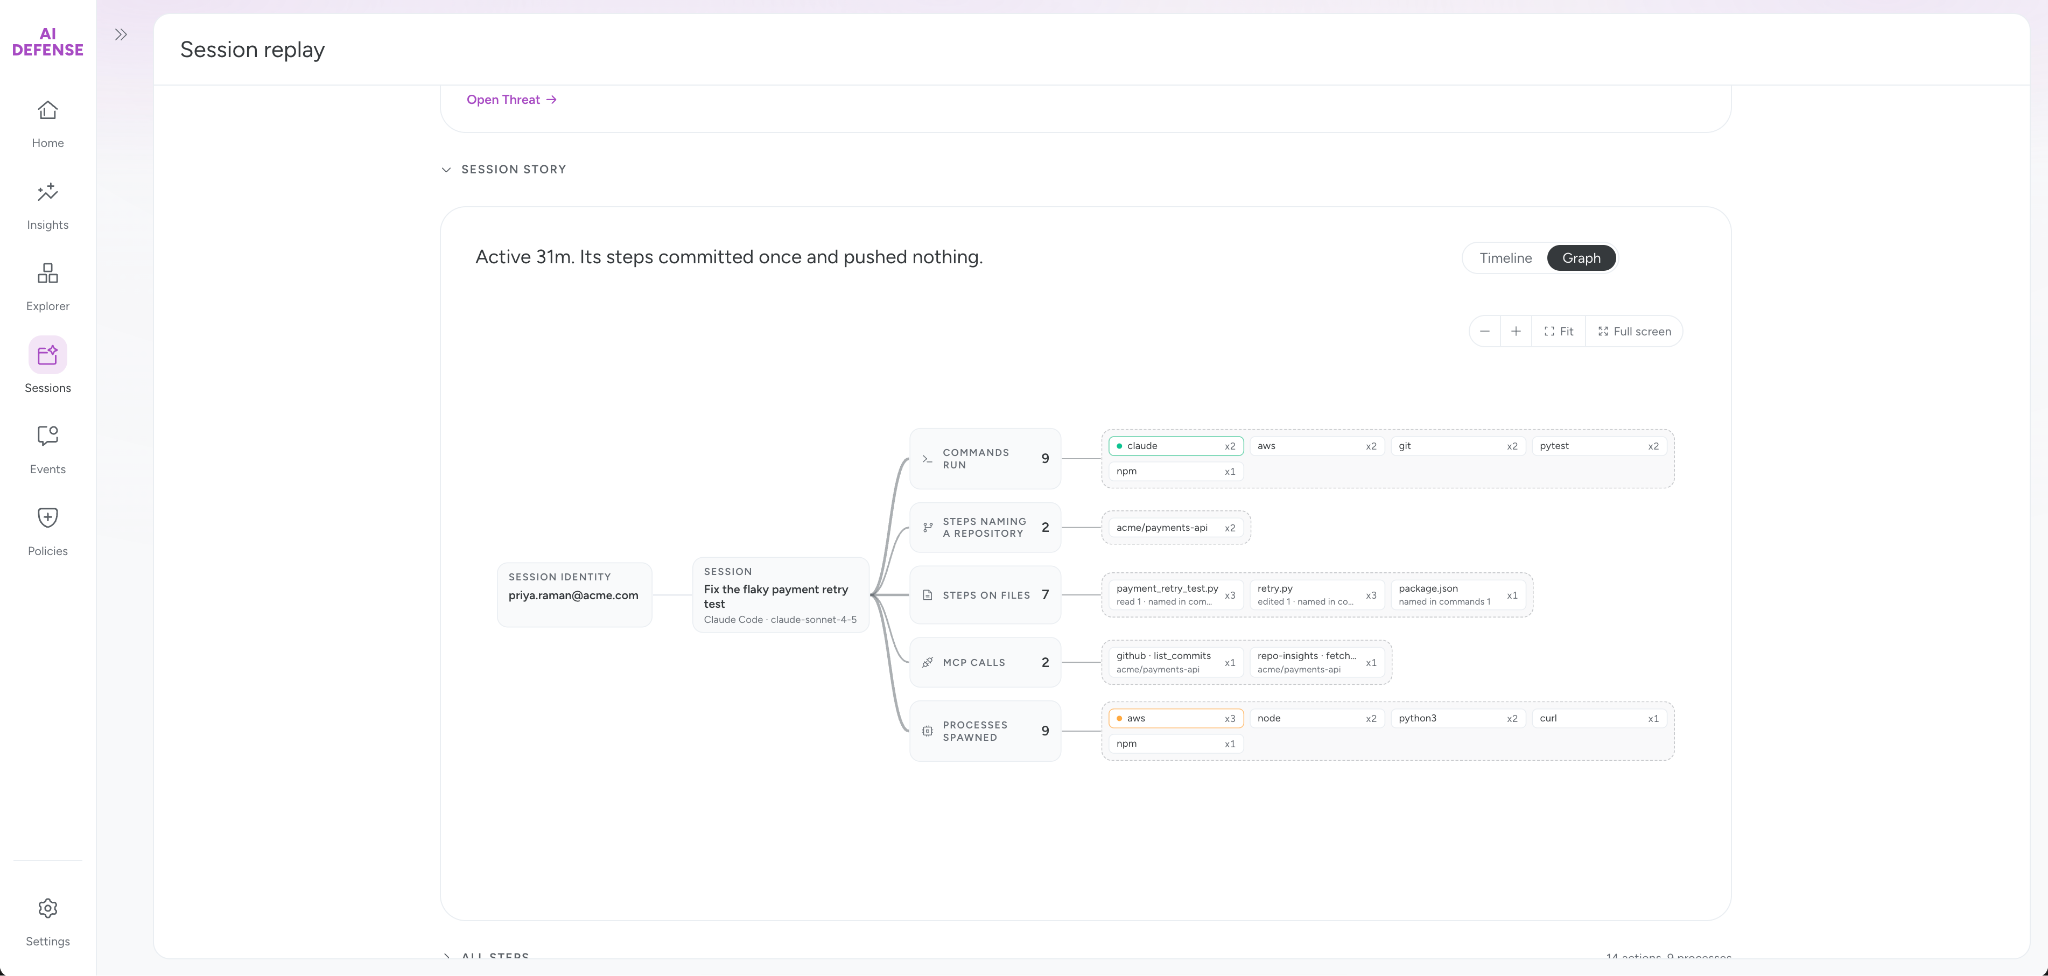
インベントリは事前に決まっていました。残る3つは、アクションが実行されている最中に判断されたものです。それが、誰も担っていなかった判断であり、私たちが作り上げたものです。
エンジニアが設定したものであれ、他の誰かが設定したものであれ、組織のどこかでエージェントが動いているなら、デモを依頼して、あなた自身のギャップがどこにあるのかを確かめてください。